DOI: 10.17175/sb007_008
Nachweis im OPAC der Herzog August Bibliothek: 1982241047
Erstveröffentlichung: 02.11.2026
Lizenz: CC BY-SA 4.0,
sofern nicht anders angegeben. 
Letzte Überprüfung aller Verweise: 24.08.2026
GND-Verschlagwortung: Digitale Edition | Annotation | Zitation | Graphdatenbank
Empfohlene Zitierweise: Andreas Kuczera: Texte als Graph in algorithmischen Editionen. Zur Entwicklung von Applied Text as Graph. In: Daniela Schulz / Marcus Baumgarten / Torsten Schaßan (Hg.): Digitales Edieren gestern, heute und morgen (= Zeitschrift für digitale Geisteswissenschaften / Sonderbände, 7). Wolfenbüttel 2026. 02.11.2026. HTML / XML / PDF. DOI: 10.17175/sb007_008
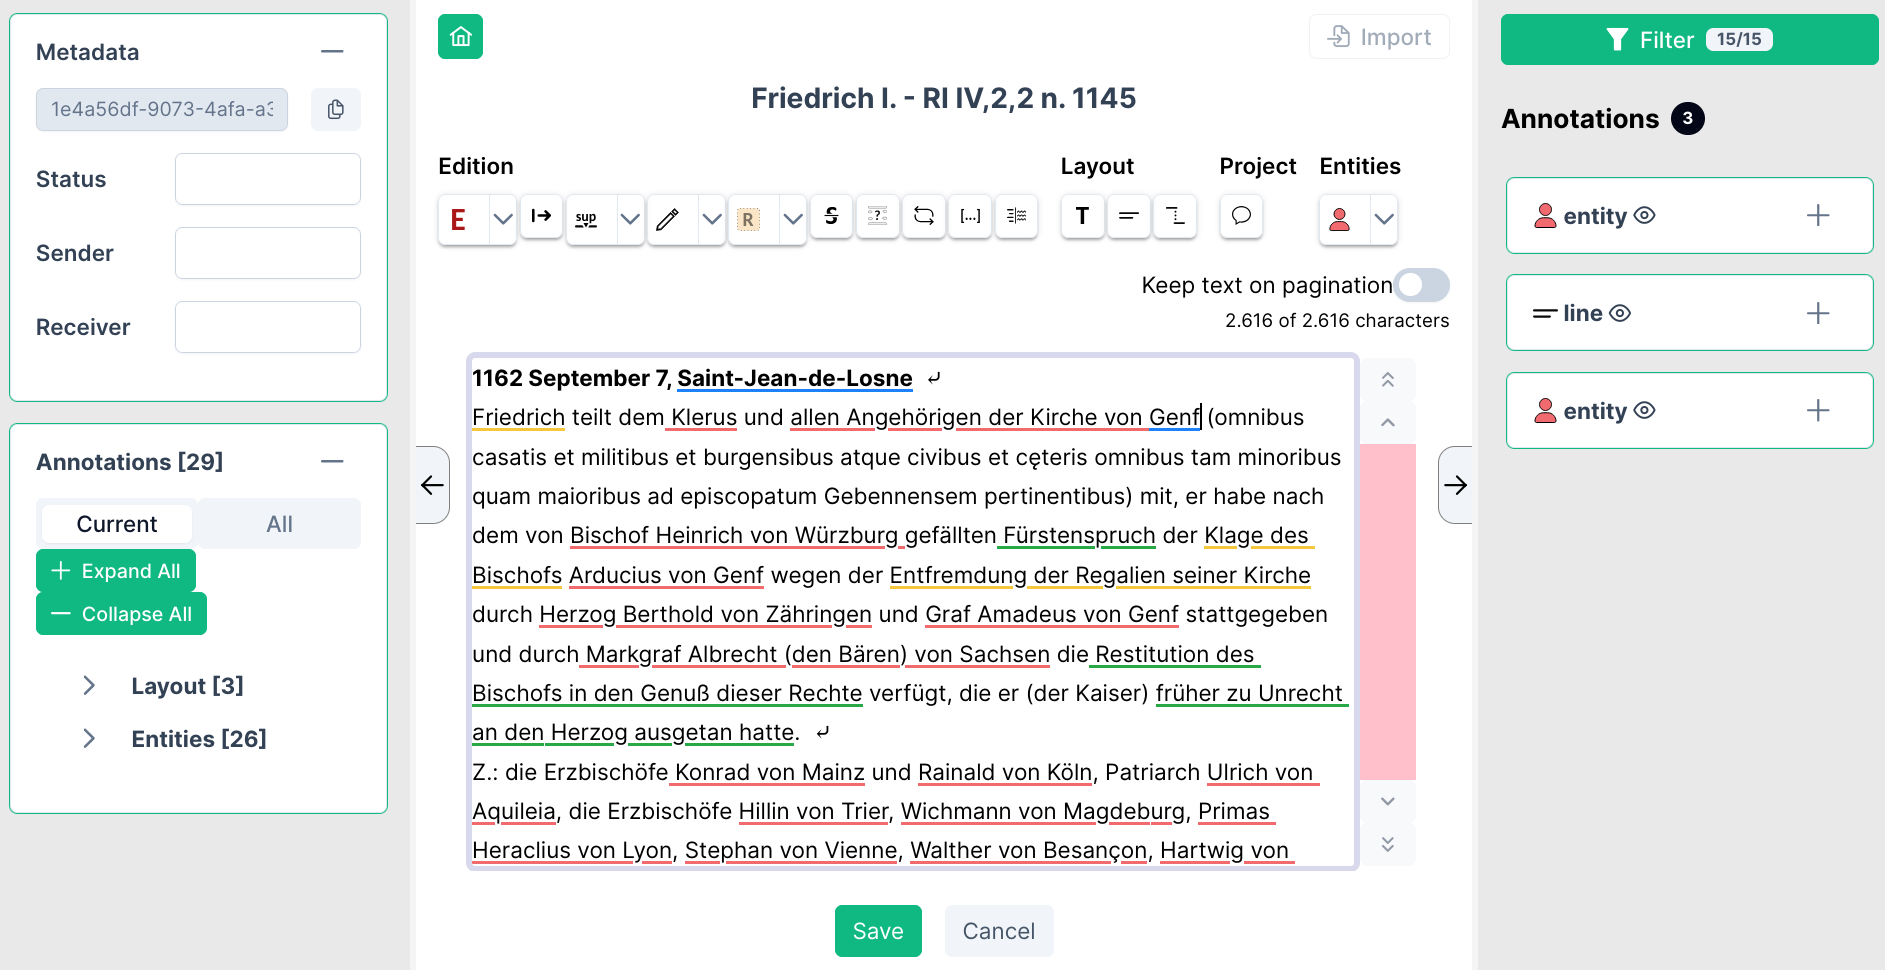
Abstract
Dieser Beitrag beschreibt die Entwicklungsgeschichte von Applied Text as Graph (ATAG) – einem graphbasierten Modell zur Textmodellierung in digitalen Editionen. Ausgehend von drei Phasen der Digitalisierung in den Geschichtswissenschaften werden die Grenzen des TEI-XML-Ansatzes sowie des Standoff-Markups skizziert. Im Mittelpunkt stehen die Grundprinzipien von ATAG, seine Implementierung in drei konkreten Editionsprojekten, die Entwicklung eines zugehörigen WYSIWYM-Editors sowie das Konzept der Explicitly Notated Citations (ENC-Links) als Grundlage für algorithmische Editionen.
This article traces the development of Applied Text as Graph (ATAG), a graph-based model for text modelling in digital scholarly editions. Drawing on three phases of digitisation in historical scholarship, the article examines the limitations of TEI-XML and standoff markup before presenting ATAG’s core principles, its implementation in three concrete edition projects, the associated WYSIWYM editor, and the concept of Explicitly Notated Citations (ENC-Links) as the foundation for algorithmic editions.
1. Einleitung
[1]Digitale Editionen haben sich in den letzten Jahrzehnten als eigenständige Publikationsform in den Geisteswissenschaften etabliert. Mit dem wachsenden Umfang digitaler Textkorpora und der zunehmenden Komplexität wissenschaftlicher Annotationsanforderungen stoßen die gängigen Textmodellierungsansätze jedoch an strukturelle Grenzen. Dieser Beitrag verfolgt die Entwicklungsgeschichte von Applied Text as Graph (ATAG), einem am Fachbereich MNI (Mathematik, Naturwissenschaften, Informatik) der Technischen Hochschule Mittelhessen entwickelten Ansatz zur graphbasierten Textmodellierung. ATAG reagiert auf die Schwächen etablierter Standards und eröffnet neue Möglichkeiten der wissenschaftlichen Texterschließung, die Editionen zugleich für menschliche Leser*innen und für algorithmische Analyseverfahren nutzbar machen.
[2]Am Beispiel der Regesta Imperii (RI) wird zunächst eine Standortbestimmung zur Digitalisierung in den Geschichtswissenschaften vorgenommen, die drei aufeinander aufbauende Phasen unterscheidet. Daran schließt eine kritische Auseinandersetzung mit den Grenzen des TEI-XML-Standards und alternativer Ansätze wie dem Standoff-Markup an, die zugleich epistemologische Fragen der digitalen Editionswissenschaft berührt.[1] Auf dieser Grundlage werden die Grundprinzipien von ATAG, seine Implementierung in drei Editionsprojekten sowie die Entwicklung eines zugehörigen Editionseditors erläutert. Den Abschluss bilden das Konzept der Explicitly Notated Citations (ENC-Links) und ein Ausblick auf algorithmische Editionen.
2. Phasen der Digitalisierung in den Geschichtswissenschaften
[3]Die Regesta Imperii sind ein zentrales historisches Grundlagenforschungsvorhaben, in dem deutschsprachige Inhaltsangaben – sogenannte Regesten – von Kaiser-, Königs- und Papsturkunden des Mittelalters erarbeitet werden. An diesem Vorhaben lassen sich exemplarisch die verschiedenen Phasen der Digitalisierung in den Geschichtswissenschaften nachvollziehen.
2.1 Imagedigitalisierung

[4]Die erste Phase der Digitalisierung war bis Ende der 1990er Jahre die Imagedigitalisierung. Dabei wurden Buchseiten fotografisch erfasst und im Netz zur Verfügung gestellt (vgl. Abbildung 1). In der Regel konnten Nutzende den Text aus diesen PDFs weder herauskopieren noch als Volltext durchsuchen. Trotz dieser Einschränkungen markierte die Imagedigitalisierung einen wesentlichen Fortschritt: Sie ermöglichte den Zugriff auf Quellen, die in der Bibliothek nicht verfügbar oder physisch schwer zugänglich waren.[2]
2.2 Volltextdigitalisierung
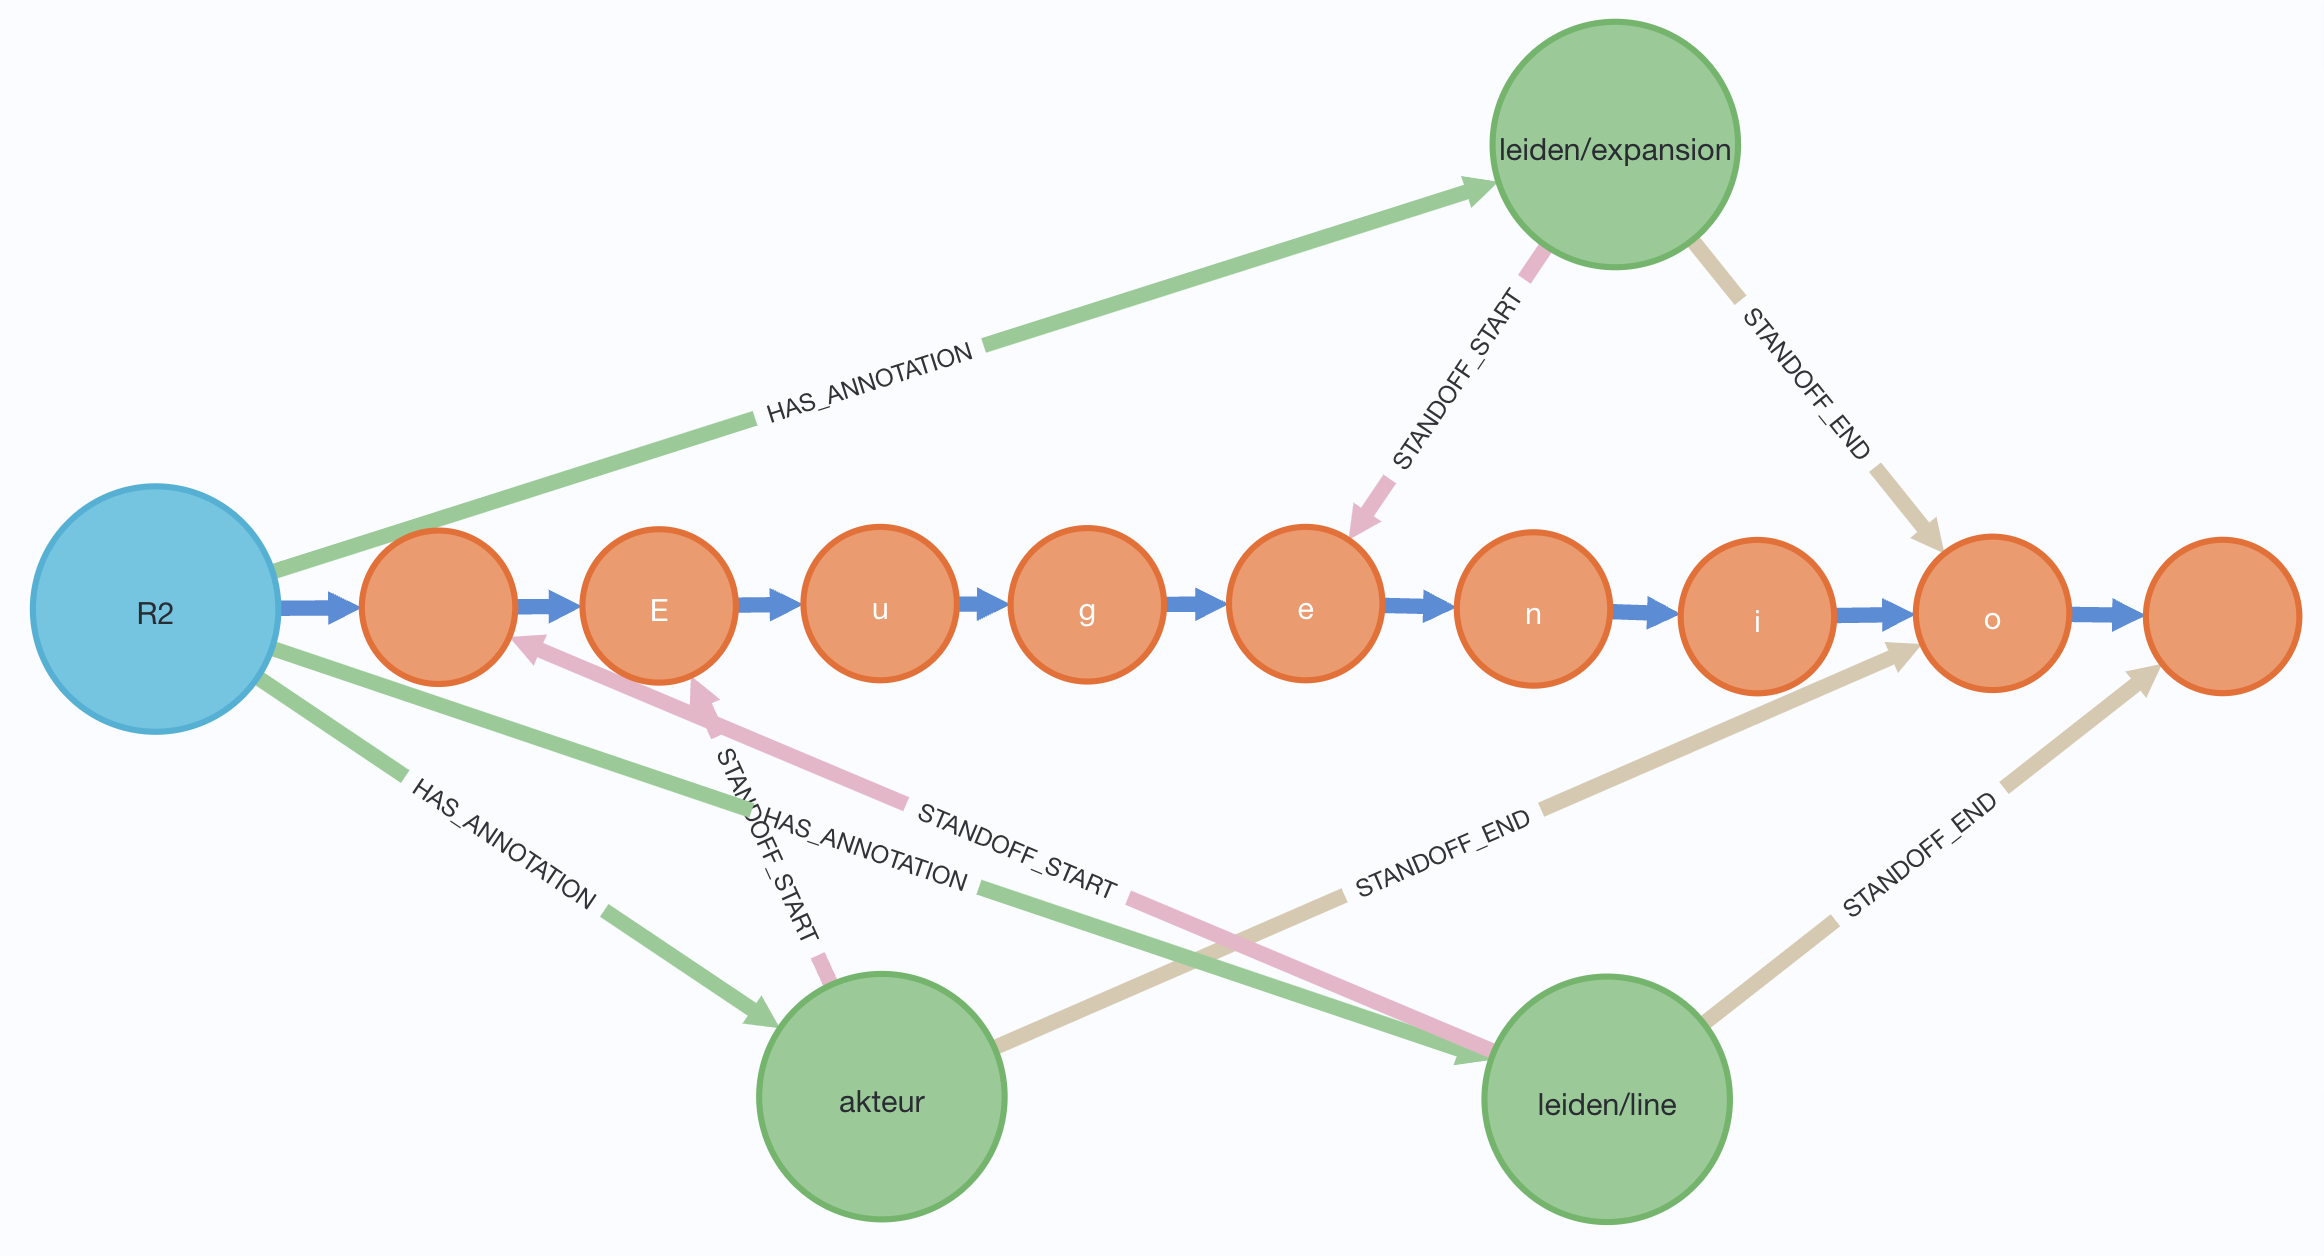
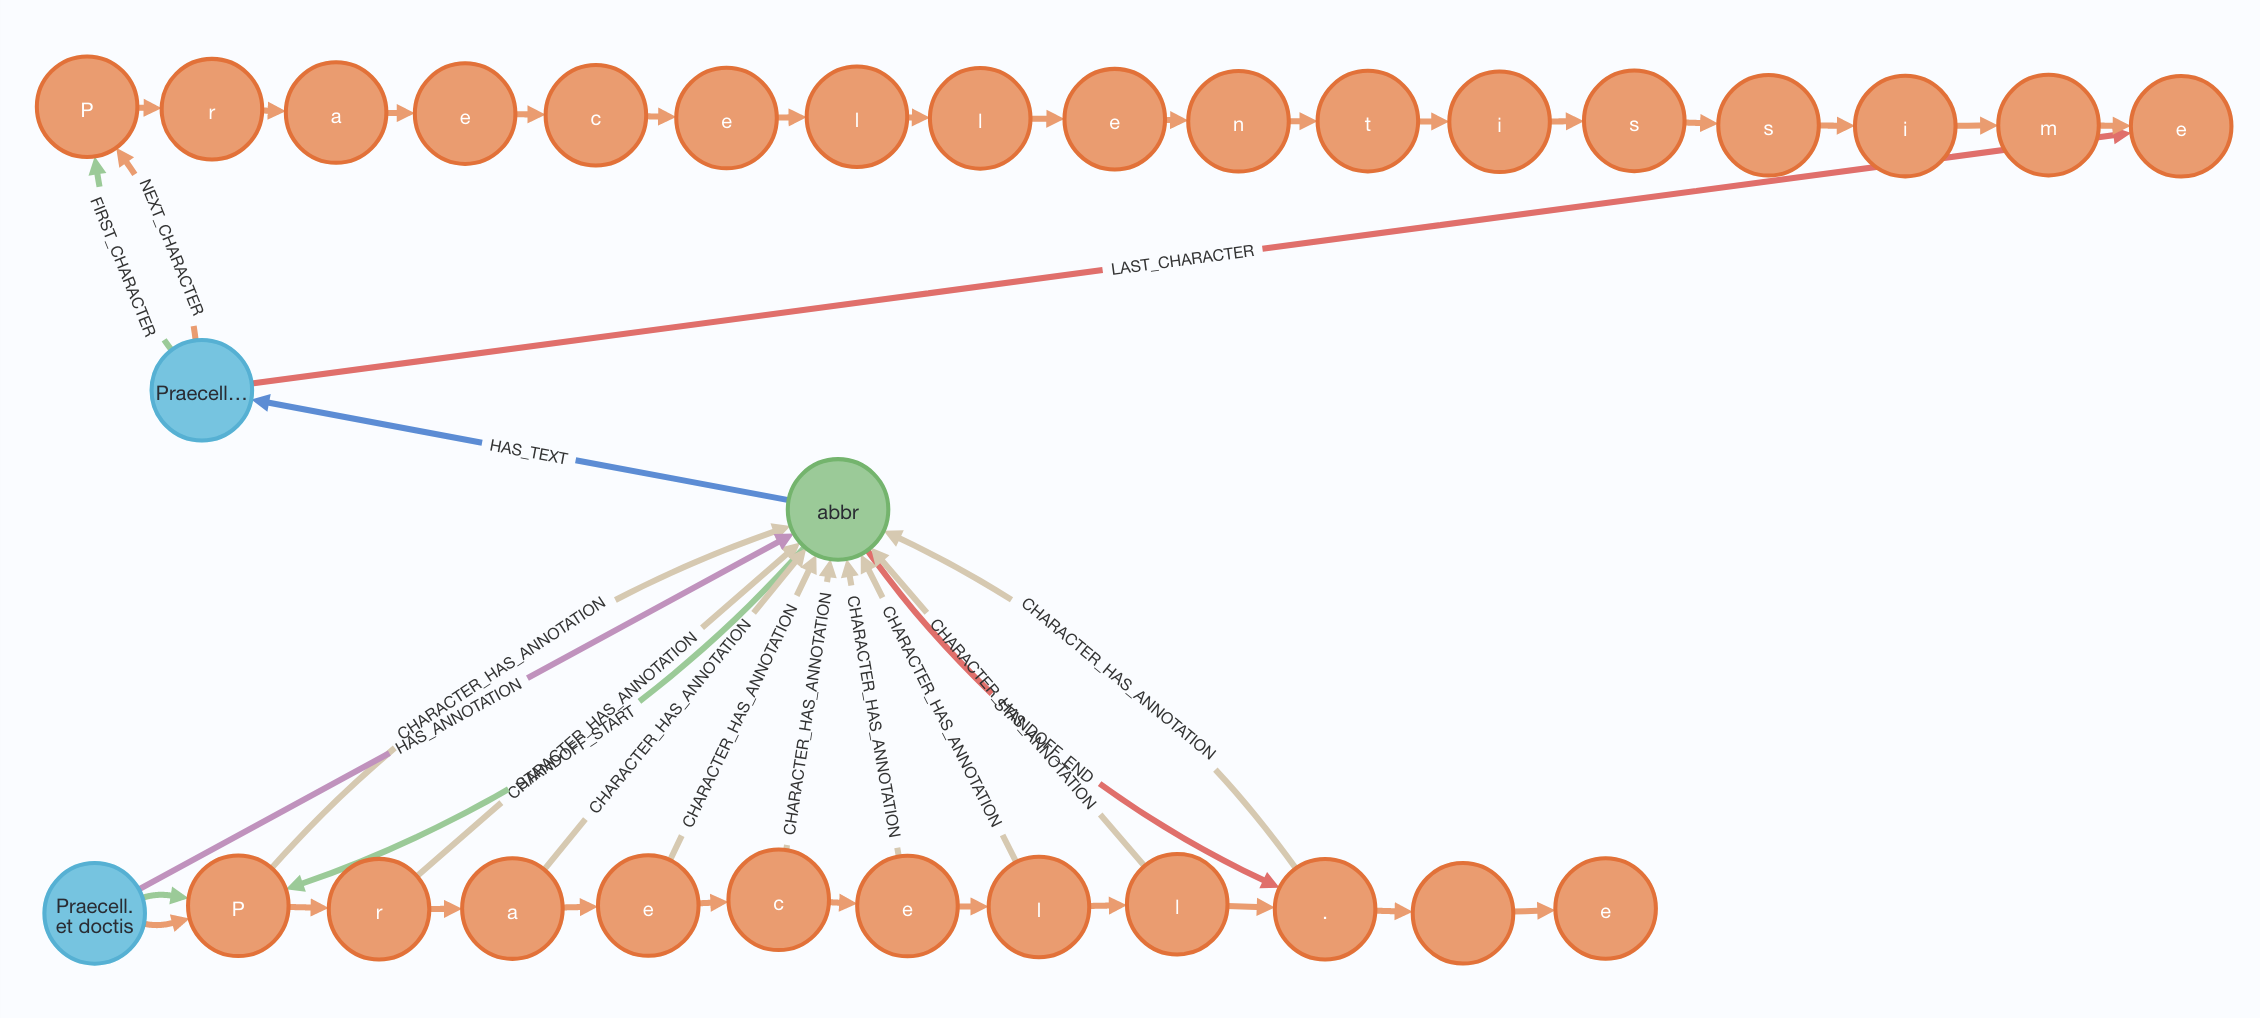
[5]Seit etwa den 2000er Jahren folgte eine zweite Phase, die Volltextdigitalisierung.

[6]Im Rahmen des DFG-Projekts zur Digitalisierung der Regesta Imperii wurden die Regesten im Volltext maschinenlesbar aufbereitet und stehen seitdem über die Webseite der Regesta Imperii online zur Verfügung (vgl. Abbildung 2). Der Text kann nicht nur kopiert, sondern auch als Volltext durchsucht werden, was völlig neue Rezeptionsmöglichkeiten eröffnete. Dabei zeigte sich jedoch schnell, dass Volltexte zahlreiche Informationen enthalten, die nur implizit vorhanden sind: Personennamen, Ortsangaben, Handlungstypen und Datierungen sind im Text der Regesten zwar lesbar, aber für den Rechner nicht als strukturierte Daten verfügbar. Eine systematische digitale Erschließung dieser verborgenen Strukturen war damit erst durch den Übergang zur nächsten Phase möglich.[3]
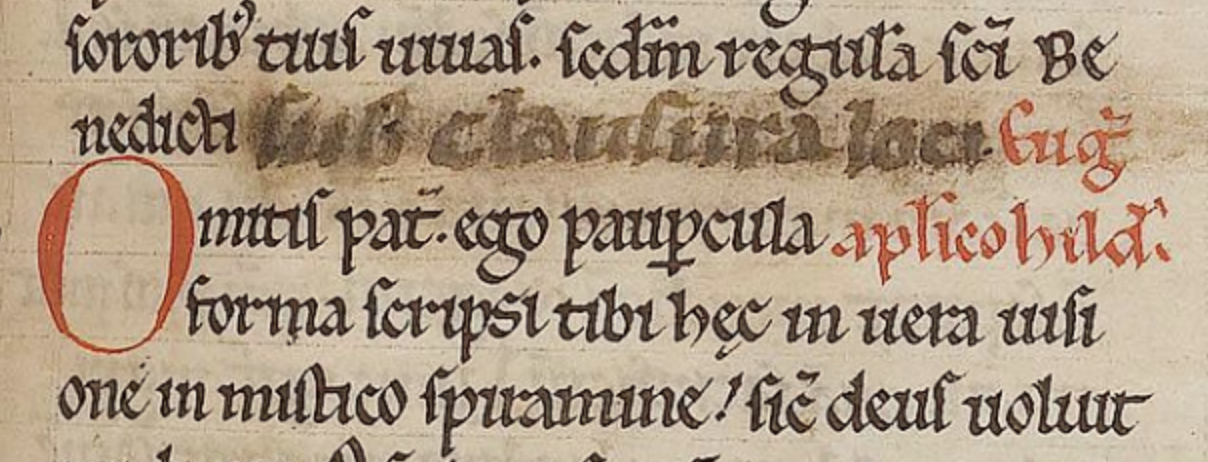
2.3 Entitätsbasierte Annotation und Graphmodellierung
[7]Gegenwärtig befinden wir uns in einer dritten Phase der Digitalisierung, in der Entitäten in den Volltexten in den Vordergrund rücken.
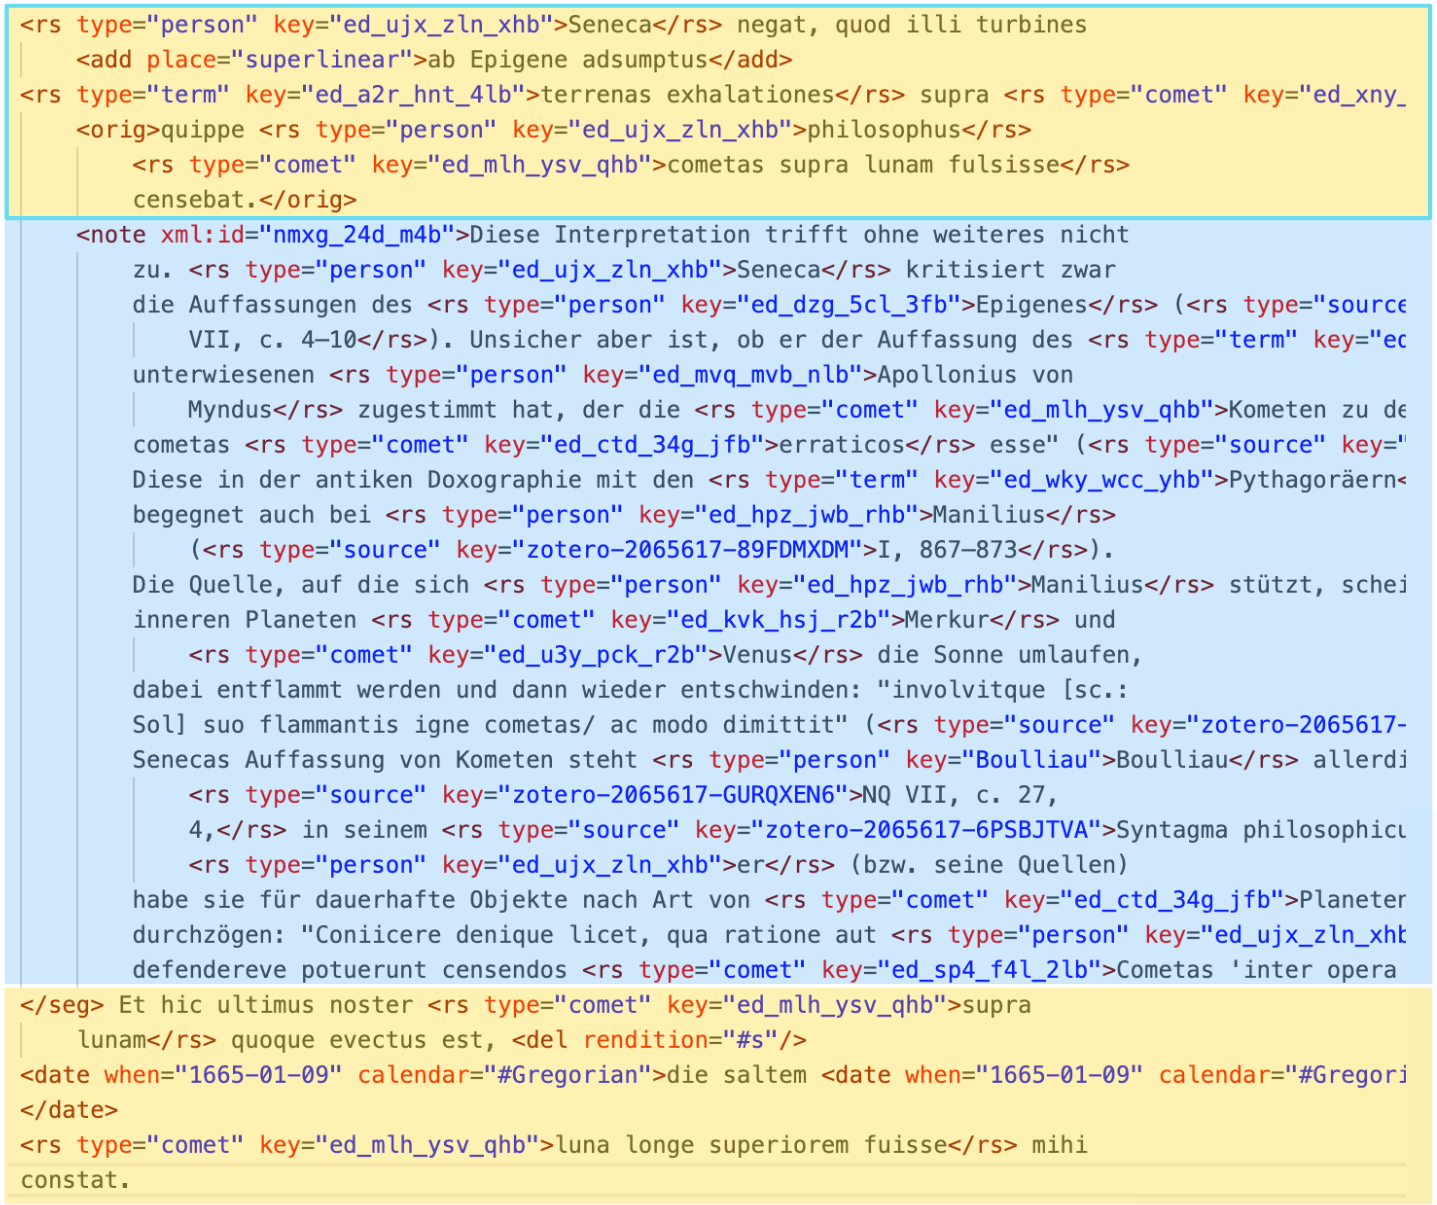
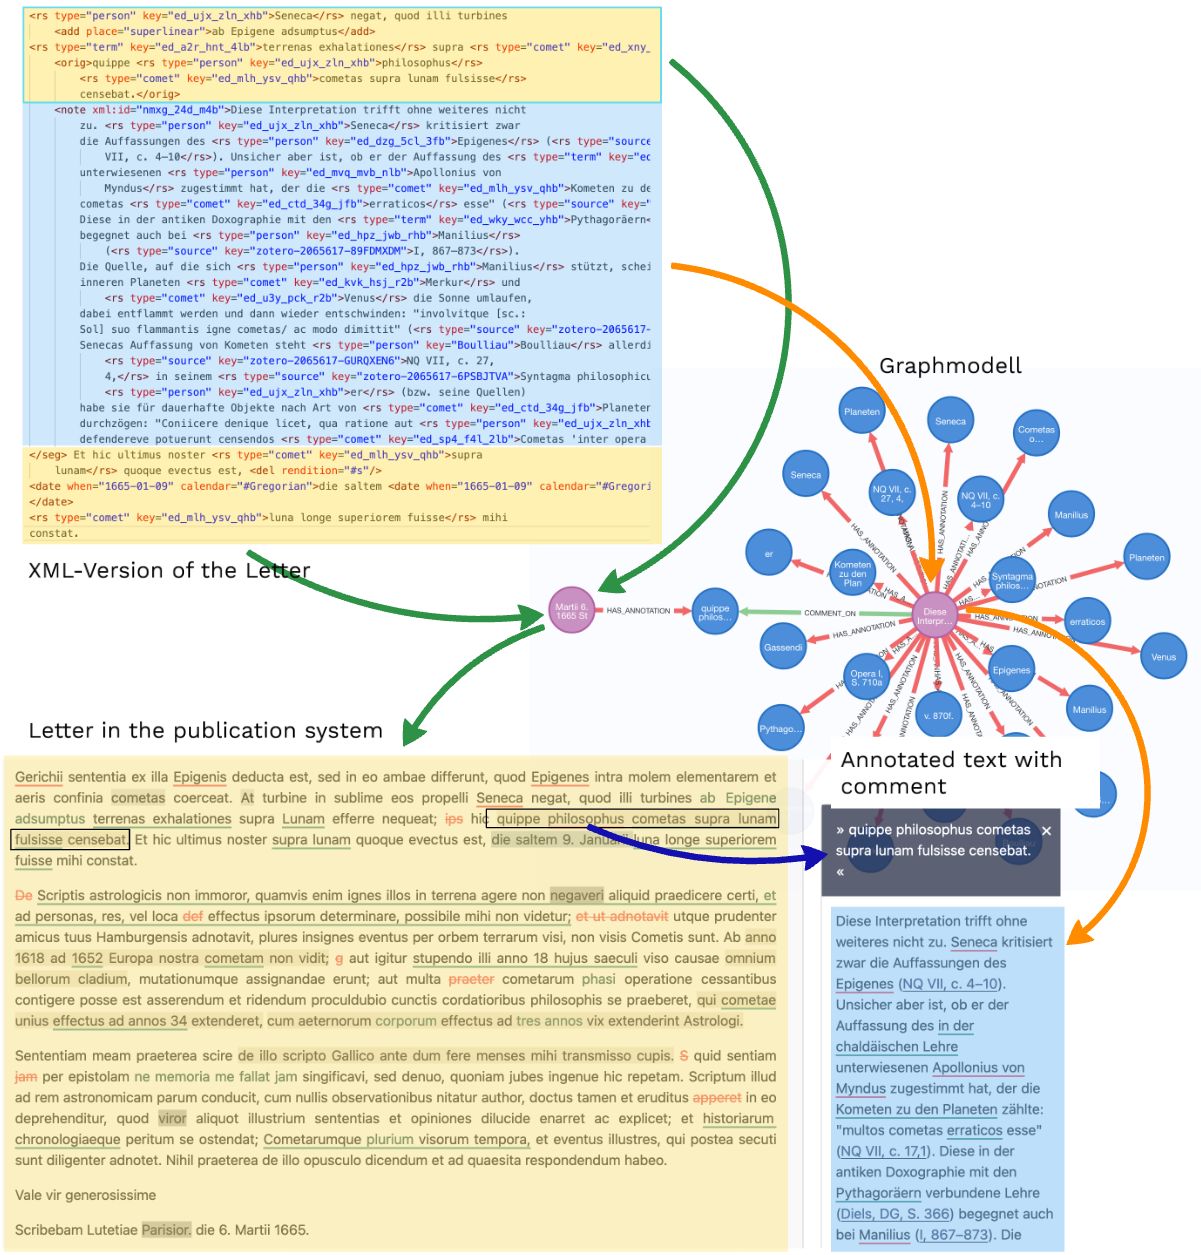
[8]In digitalen Editionsumgebungen wie dem ATAG-Editor (vgl. Abbildung 3) werden Personen (z. B. Bischof Heinrich von Würzburg), Orte (z. B. Genf) und Konzepte (z. B. Fürstenspruch) im Volltext annotiert und mit Normdatensystemen wie der Gemeinsamen Normdatei (GND) oder Wikidata verknüpft. Diese Verknüpfung ermöglicht es, Entitäten über Projektgrenzen hinweg in ihren jeweiligen Kontexten zu vergleichen.[4]
[9]Die drei Beispiele zeigen die Entwicklung hin zu graphdatenbasierten Datenmodellierungen auf, die entitätsbasierte Erschließung erheblich erleichtern. Während mehrstufige Netzwerkabfragen – etwa die Frage, welche Personen über fünf Zwischenstationen miteinander verbunden sind – in relationalen Systemen viele Stunden in Anspruch nehmen können, liefert eine Graphdatenbank wie Neo4j das Ergebnis in Sekundenbruchteilen.[5] Damit eröffnen sich völlig neue analytische Perspektiven. Die räumlich-zeitliche Verteilung von Urkundenausstellungen, die Netzwerkstrukturen mittelalterlicher Akteure oder die Erkennbarkeit von Regierungsmustern lassen sich nun auf der Grundlage von Graphabfragen systematisch untersuchen.
[10]Dabei beschränkt sich die Annotationspraxis nicht mehr auf die Identifizierung von Personen, Orten und Konzepten. Hinzu kommen fachliche und inhaltliche Kommentare verschiedener Nutzer*innengruppen sowie mehrschichtige Annotationen zu Layout, Syntax, Sprache etc. Hier kommt die besondere Flexibilität graphbasierter Modelle ins Spiel, die im Folgenden näher beschrieben wird.
3. Herausforderungen der Textmodellierung
[11]Im Bereich des Digital Scholarly Editing (DSE) wurden erhebliche Fortschritte erzielt, insbesondere durch die Einführung von Standards wie TEI-XML[6] und die Einhaltung der FAIR-Prinzipien.[7] Dennoch stehen digitale Editionen weiterhin vor erheblichen technischen und epistemologischen Herausforderungen. Elisa Cugliana, Aengus Ward, Joris J. van Zundert, Max Grüntgens und ich haben jüngst darauf hingewiesen, dass digitale Editionswissenschaft seit Jahrzehnten einem fundamental konservativen Modell folgt, das die epistemologischen Möglichkeiten des Digitalen nur unvollständig ausschöpft. Editionsprojekte tendieren dazu, das gedruckte Paradigma zu replizieren, statt Texte als dynamische, prozessuale Wissenssysteme zu begreifen.[8]
3.1 Das OHCO-Modell und seine Grenzen
[12]In aktuell häufig genutzten Systemen mit TEI-XML wird der Text in der Regel als geordnete Hierarchie von Inhaltsobjekten (Ordered Hierarchy of Content Objects, OHCO) dargestellt.[9] Annotationen werden dabei als Inline-Markup direkt in den edierten Text eingebettet. Dieser Ansatz stößt bei einer größeren Anzahl von Annotationshierarchien an seine Grenzen, insbesondere wenn sich diese überschneiden. Dino Buzzetti[10], Steven DeRose und seine Mitautor*innen[11] sowie Ronald Haentjens Dekker und David J. Birnbaum[12] haben auf die damit verbundenen Probleme der Adressierbarkeit, der Persistenz von Textelementen und der digitalen Repräsentation kleiner Texteinheiten hingewiesen.
[13]Die zirkuläre Argumentation zugunsten des OHCO-Modells zeigt sich exemplarisch in der Formulierung von Allen Renear: »The comparative efficiency and functionality of treating texts as if they were OHCOs is best explained, according to this argument, by the hypothesis that texts are OHCOs.«[13] Dies ist letztlich eine selbstreferenzielle Begründung mit begrenzter theoretischer Reichweite.
3.2 Standoff-Markup als Alternative
[14]Aus der Computerlinguistik stammt ein alternativer Ansatz, nämlich das Standoff-Markup. Hier wird Text primär als Zeichenabfolge betrachtet.[14] Annotationen werden separat als eigenständige Einheiten gespeichert und referenzieren die entsprechenden Zeichenpositionen über Indexverweise.[15] Der Vorteil gegenüber Inline-XML liegt in der klaren Trennung von Basistext und Annotation, was sich überschneidende Annotationshierarchien ermöglicht. Der entscheidende Nachteil besteht jedoch darin, dass der Basistext nach der Indizierung nicht mehr verändert werden darf, ohne sämtliche Verweise zu invalidieren. Dies ist eine erhebliche Einschränkung für kollaborative oder langfristige Editionsprojekte.
4. Applied Text as Graph (ATAG)
4.1 Grundprinzipien
[15]Applied Text as Graph (ATAG) nimmt die Vorzüge des Standoff-Ansatzes auf und überwindet zugleich dessen Einschränkungen. Ihr Grundprinzip besteht darin, einen Basistext als Kette von Zeichenknoten in einer Labeled-Property-Graphdatenbank zu realisieren und jeden Knoten mit einer eindeutigen UUID (Universal Unique Identifier) zu versehen, die seine dauerhafte Adressierbarkeit sicherstellt.[16]

[16]Die wesentlichen strukturellen Elemente von ATAG sind (vgl. Abbildung 4):
- Zeichenknoten (orange): Jedes Zeichen des Basistextes wird in einem eigenen Knoten gespeichert. Diese Knoten sind sequenziell miteinander verbunden (NEXT-Kanten) und bilden so die lineare Abfolge des Textes nach – den sogenannten Textstream. Über FIRST_CHARACTER- und LAST_CHARACTER-Kanten wird der Geltungsbereich einer Annotation explizit definiert.
- Textknoten (blau): Jeder Textblock beginnt mit einem Textknoten, der als Wurzelelement fungiert und in seiner ›text‹-Eigenschaft den Volltext als Plaintext speichert. Mehrere Textknoten können zu einer vorgeschlagenen Lesereihenfolge verbunden werden.
- Annotationsknoten (grün): Annotationen werden als eigenständige Knoten gespeichert und mit den Zeichenknoten verknüpft, auf die sie sich beziehen. Sie können semantische Informationen (z. B. Personenidentifikation nach GND) oder Layoutinformationen (z. B. Fett- oder Kursivdruck) aufnehmen. Annotationsknoten können ihrerseits mit weiteren Textknoten verbunden sein, die beispielsweise den Kommentartext enthalten – diese wiederum können annotiert werden, sodass ein beliebig tief verschachteltes Netzwerk von Texten und Annotationen entsteht.
[17]ATAG beginnt bewusst auf der Ebene des einzelnen Zeichens (Glyphe), was insbesondere für mittelalterliche Texte mit komplexen Abkürzungspraktiken, uneinheitlicher Orthographie und visuell distinkten Buchstabenformen von Bedeutung ist: Die Zeichenebene ist die unterste gemeinsame Referenzgröße, auf der alle weiteren Annotationsschichten aufbauen.[17] Die Granularität ist dabei flexibel: In Forschungskontexten, die auf Token-Ebene operieren, können mehrere Zeichen in einem Knoten modelliert oder Zeichen- und Token-Ebene in einem integrierten Graphen kombiniert werden. Darüber hinaus macht das System keine Vorgaben hinsichtlich der Metadatenverwaltung; Metadaten können etwa in TEI-konformen Metadatenknoten abgelegt werden.[18]
[18]Im Gegensatz zu TEI-XML ermöglicht dieses Modell ohne Einschränkung überlappende Annotationshierarchien, z. B. Layout, Stil, Entitäten, Syntax, Morphologie, Sprache etc. Der Textstream kann dynamisch aktualisiert werden, ohne dass bestehende Annotationen ihre Gültigkeit verlieren. Zur Leistungsfähigkeit des Ansatzes liefert ein Skalierungstest aufschlussreiche Zahlen: Der Import von über 200.000 Regesten aus den Regesta Imperii Online dauerte ca. 100 Minuten und erzeugte rund 120 Millionen Knoten und Kanten.[19]
4.2 Implementierungsbeispiele
Liber Epistolarum der Hildegard von Bingen
[19]Im Projekt Liber Epistolarum ist der Basistext als normalisierte Fassung des lateinischen Textes im Textstream gespeichert. Das von der Deutschen Forschungsgemeinschaft (DFG) geförderte Projekt ›Das Buch der Briefe der Hildegard von Bingen. Genese – Struktur – Komposition‹ wird unter der Leitung von Mechthild Dreyer, Andreas Kuczera und Thomas Stäcker durchgeführt und ist an der Akademie der Wissenschaften und der Literatur Mainz angesiedelt. Ziel ist die digitale Edition des Liber epistolarum aus dem sogenannten Riesenkodex sowie die Untersuchung der Überlieferung, Struktur und Komposition der Briefsammlungen Hildegards von Bingen. Die graphbasierte Editionsumgebung ermöglicht dabei die differenzierte Erfassung textkritischer, struktureller und inhaltlicher Annotationen. Abbildung 5 zeigt den Textknoten des Briefes R2 mit den ersten Zeichenknoten und Annotationen in der Graphdatenbank Neo4j.

[20]Der grüne Annotationsknoten zeigt, dass ein Teil des ersten Tokens (›Eugenio‹) vom Editor ergänzt wurde – im Original sind lediglich die ersten drei Zeichen überliefert. Zwei weitere Annotationsknoten verweisen auf die Klassifizierung als Akteur in der digitalen Edition sowie auf eine Zeilenannotation.[20]
[21]Der Textstream bildet die Grundlage sowohl für den Editionsprozess als auch für die Webpublikationsumgebung (vgl. Abbildung 6 und Abbildung 7). Textknoten mit ihrer Texteigenschaft und die Zeichenkette werden stets synchron gehalten: Die Kette dient der Editierung, Annotation und algorithmischen Forschung; die Texteigenschaft wird für das Publikationssystem genutzt.
Sozinianische Briefe
[22]Im Sozinianischen Briefprojekt folgt ATAG einem anderen redaktionellen Ansatz. Das an der Akademie der Wissenschaften und der Literatur Mainz und der Niedersächsischen Akademie der Wissenschaften zu Göttingen verankerte Forschungsvorhaben ›Religion und Naturwissenschaft im Umbruch: Sozinianische Briefwechsel und Inedita digital‹ wird von Kęstutis Daugirdas und Andreas Kuczera geleitet. Es widmet sich der historisch-kritischen digitalen Edition sozinianischer Briefwechsel und bislang ungedruckter Schriften aus der Zeit von etwa 1550 bis 1750. Im Mittelpunkt stehen die transnationalen Kommunikationsnetzwerke der Sozinianer und deren Bedeutung für die Entwicklung religiöser Toleranz, theologischer Diskurse und naturwissenschaftlicher Erkenntnisse in der Frühen Neuzeit. Die graphbasierte Edition ermöglicht es, Texte, Personen, Orte und Sachzusammenhänge miteinander zu verknüpfen und algorithmisch auszuwerten. Hier bildet die Originaltranskription den Textstream, während normalisierte Formen als Annotationen gespeichert werden (vgl. Abbildung 8). Dieser Unterschied verdeutlicht ein grundlegendes Merkmal von ATAG, denn das System erzwingt keine bestimmte editorische Philosophie, sondern unterstützt unterschiedliche Ansätze gleichermaßen. Die Entscheidung liegt bei den jeweiligen Projekten.
[23]Ein anschauliches Beispiel für die Stärken des Graphmodells gegenüber TEI-XML bietet der Brief von Ismaël Boulliau an Stanisław Lubieniecki vom 6. März 1665. In TEI-XML werden Transkriptionstext und Kommentartext des Herausgebers in einem einzigen Zeichenstrom vermischt (vgl. Abbildung 9).

[24]In ATAG hingegen werden diese Informationshierarchien klar getrennt (vgl. Abbildung 10): Eine HAS_ANNOTATION-Kante verbindet den Textknoten mit einem Annotationsknoten; eine COMMENT_ON-Kante führt zu einem weiteren Textknoten mit dem Kommentartext. Dieser Aufbau ermöglicht Annotationen in Annotationen – ein Netzwerk miteinander verbundener Texte entsteht (vgl. Abbildung 11 und Abbildung 12).

5. Der ATAG-Editor
[25]Da kein geeignetes Werkzeug zur Erstellung, Bearbeitung, Kommentierung und Speicherung von direkt im Graphen modellierten Texten verfügbar war, wurde der webbasierte ATAG-Editor entwickelt.

[26]Sein Vorgänger, der Standoff Property Editor SPEEDy[21], stieß bei langen Texten ab ca. 15.000 Zeichen mit zahlreichen Annotationen an Leistungsgrenzen, da er den gesamten Text in den Browsercache lud. Der ATAG-Editor setzt auf ein WYSIWYM-Prinzip (What You See Is What You Mean): Er lädt ausschließlich Teile des Textstreams (Chunks), die er aus der Zeichenkette der Graphdatenbank abruft, und verarbeitet den Text abschnittsweise (vgl. Abbildung 13). Die Chunk-Größe ist konfigurierbar. Annotationen werden durch visuelle Elemente wie Unterstreichungen, Schriftfarbe oder Hintergrundfarbe hervorgehoben, ohne den Lesefluss des Basistextes zu beeinträchtigen.[22] Dieses Anzeigekonzept ist von Annotationswerkzeugen wie CATMA oder INCEpTION bekannt. Der ATAG-Editor ermöglicht jedoch als bislang einziges Werkzeug, den zugrundeliegenden Basistext gleichzeitig zu annotieren und zu bearbeiten. Die intuitive Benutzer*innenoberfläche – Annotationen durch Markieren und Anklicken von Schaltflächen – macht den Editor besonders zugänglich. Als nächster Entwicklungsschritt wird mit dem RAMEN-Framework eine Abstraktionsschicht erprobt, die es verschiedenen Editionsprojekten ermöglicht, ihre domänenspezifischen Modelle auf der Basis eines gemeinsamen Metamodells zu definieren und so Interoperabilität herzustellen, ohne projektspezifische Semantiken aufgeben zu müssen.[23]
6. ENC-Links: Präzise Zitation in digitalen Editionen
[27]Zitate sind für die wissenschaftliche Arbeit unverzichtbar: Sie belegen Quellen und ermöglichen die Rückverfolgung von Ideen. In gedruckten Werken wird traditionell auf Seitenzahlen verwiesen. Diese Methode stößt in digitalen Formaten mit dynamischen Layouts an ihre Grenzen. Allgemeine URLs sind unzuverlässig, Permalinks scheitern bei parametrisierten oder dynamischen Textansichten und Canonical Text Services[24] (CTS)-URNs bieten Persistenz, aber eine hierarchische Starrheit, die für überlappende Annotationsstrukturen ungeeignet ist. Das W3C Web Annotation Model bietet einen standardisierten Rahmen für digitale Annotationen, aber nicht die für präzise wissenschaftliche Zitate erforderliche Granularität.
[28]ATAG überwindet diese Einschränkung durch das Konzept der Explicitly Notated Citations (ENC-Links). Da in ATAG jedes Zeichen mit einer UUID oder seinem Textstream eindeutig adressierbar ist, können ENC-Links auf einzelne Zeichenfolgen bis auf Zeichenebene präzise verweisen – eine Granularität, die kein bisheriges Zitationssystem für digitale Editionen erreicht.[25]
[29]Die Struktur eines ENC-Links umfasst folgende Komponenten:
https://www.sozinianer.de/id/MAIN_ed_kbj_wfw_xmb?guid=ed_kbj_wfw_xmb&s=7261&e=7324
- Basisadresse: Identifiziert die Edition.
- Kommunikations-ID: Bezeichnet den Kommunikationskontext (MAIN_ed_kbj_wfw_xmb).
- Varianten-ID: Spezifiziert die Textvariante (ed_kbj_wfw_xmb).
- Startindex (s=7261) und Endindex (e=7324): Bestimmen den zitierten Textabschnitt.
[30]Wird ein ENC-Link im Browser geöffnet, wird der zitierte Textabschnitt unmittelbar hervorgehoben, was die Überprüfbarkeit wissenschaftlicher Verweise erheblich erleichtert. In einer weiterentwickelten Version können Startindex und Endindex durch die UUIDs der betreffenden Zeichenknoten ersetzt werden, was die Stabilität von Zitaten auch bei Textveränderungen gewährleistet. Für die Persistenz und Integrität von Zitaten sieht das ENC-Konzept zukünftig zwei ineinandergreifende Mechanismen vor: Erstens ermöglicht ein Hash-Parameter im Zitierlink eine Integritätsprüfung – stimmt der Hash nicht mit dem aktuellen Zustand des Textes überein, werden Nutzende über die Textänderung informiert. Zweitens können Textknoten und Annotationen via Git versioniert werden. Commit-Hashes werden in den Zitierlink integriert, sodass frühere Textzustände jederzeit abrufbar bleiben.[26]
[31]ENC-Links unterstützen zudem mehrere Serialisierungsformate: Der zitierte Text einschließlich seiner Annotationen kann in Formaten wie JSON exportiert werden[27], was maschinelle Analysen und die nahtlose Integration in computergestützte Arbeitsabläufe ermöglicht. Damit schlagen ENC-Links eine Brücke zwischen nutzer*innen freundlicher wissenschaftlicher Darstellung und algorithmischer Weiterverarbeitung – und stellen zugleich das zentrale Bindeglied zwischen digitaler und algorithmischer Edition dar.
7. Algorithmische Editionen
[32]Die methodischen Entwicklungen von ATAG und ENC-Links bilden die Grundlage für das übergeordnete Ziel algorithmischer Editionen.[28] Eine algorithmische Edition legt den Schwerpunkt auf die maschinell verarbeitbare Strukturierung von Texten, Kommentaren und Metadaten, ohne dabei die Zugänglichkeit für die traditionelle wissenschaftliche Nutzung aufzugeben.
[33]Aktuelle digitale Editionen leiden häufig an drei miteinander verbundenen Problemen:
- Fragile Verankerung – Annotationen Dritter, die an HTML-Strukturen gebunden sind, versagen bei Layout-Änderungen oder Inhaltsverlagerungen.
- Mangelnde Persistenz von Links – allgemeine URLs sind unzuverlässig und Permalinks berücksichtigen parametrisierte Textansichten nicht.
- Unzureichende Granularität – ohne kapitel-, absatz- oder zeilenweise Referenzierbarkeit lassen sich Textfragmente algorithmisch kaum identifizieren.[29] ATAG zusammen mit ENC-Links löst alle drei Probleme systematisch.
[34]Im Gegensatz zu konventionellen digitalen Editionen, die häufig visuelle Schnittstellen als primären Interaktionskanal nutzen, sind algorithmische Editionen nicht auf Websites oder grafische Oberflächen angewiesen. Sie können als Netzwerke miteinander verbundener, eindeutig adressierbarer Datenpunkte vorliegen und in beliebige digitale Ökosysteme integriert werden. Die granulare Textrepräsentation von ATAG gewährleistet, dass sämtliche Textbestandteile, Annotationen und Metadaten direkt zugänglich sind; ENC-Links ermöglichen den gezielten Abruf spezifischer Textsegmente mit zugehörigen Annotationen in maschinenlesbaren Formaten.
[35]Algorithmische Editionen eröffnen damit neue Möglichkeiten für die interdisziplinäre Forschung: Sie erlauben die algorithmische Analyse sowohl von Texten als auch von Annotationen und unterstützen eine tiefere, strukturierte Texterschließung, die über das hinausgeht, was menschliche Lesende allein leisten können. Texte werden zu dynamischen, maschinenlesbaren Ressourcen, indem sie die Kluft zwischen menschenzentrierter Wissenschaft und computergestützter Analyse überbrücken.
8. Fazit
[36]Die Entwicklung von Applied Text as Graph (ATAG) markiert einen methodischen Fortschritt in der digitalen wissenschaftlichen Edition. Indem ATAG Texte in ein graphbasiertes Modell überführt, das auf der Ebene einzelner Zeichen operiert, überwindet es die strukturellen Grenzen des OHCO-basierten TEI-XML-Ansatzes sowie die Unveränderlichkeitsrestriktionen des Standoff-Markups. Das Ergebnis ist ein flexibles, interoperables Framework, das simultane überlappende Annotationshierarchien, dynamische Textbearbeitung und eindeutige Adressierbarkeit aller Textelemente verbindet.
[37]Die Implementierungen im Liber-Epistolarum-Projekt und im Sozinianischen Briefwechselprojekt zeigen, dass ATAG unterschiedliche editorische Philosophien und Textstrukturen unterstützt, ohne ein bestimmtes Vorgehen vorzuschreiben. Der ATAG-Editor als WYSIWYM-Editierumgebung und ENC-Links als präzises Zitationsinstrument mit UUID-basierter Adressierung, Hash-Verifikation und Git-Versionierung ergänzen das Framework zu einem kohärenten System.
[38]Auf epistemologischer Ebene trägt ATAG dazu bei, editorische Entscheidungen explizit und nachvollziehbar zu machen: Wenn Editorische Entscheidungen in einem Graphen formuliert werden, können implizite Annahmen über Textstrukturen sichtbar gemacht werden. Die Frage, was ein Text ist, wird nicht durch ein universelles Modell beantwortet, sondern bleibt Gegenstand wissenschaftlicher Reflexion.
[39]Mit dem Konzept der algorithmischen Editionen wird der Horizont dieser Entwicklungen deutlich. Es geht nicht nur darum, Texte besser digital darzustellen, sondern auch darum, sie als dynamische, maschinenlesbare Ressourcen zu konstituieren, die von menschlichen Lesenden und algorithmischen Analysemethoden gleichermaßen genutzt werden können. Damit leistet ATAG einen Beitrag zur Überbrückung der Kluft zwischen geisteswissenschaftlicher Hermeneutik und computergestützter Textanalyse und eröffnet damit neue Wege für die interdisziplinäre Forschung in den Digital Humanities.
Fußnoten
-
[1]Vgl. Cugliana et al. 2024a.
-
[2]Vgl. Rübsamen / Kuczera 2006.
-
[3]Vgl. Kuczera 2019.
-
[4]Vgl. Kuczera 2019.
-
[5]Vgl. Kuczera 2019, S. 158–159. Abfragezeiten: 0,07 Sekunden in Neo4j gegenüber 25 Stunden in MySQL für identische Fünf-Grad-Netzwerkabfragen.
-
[6]Vgl. Cummings 2012.
-
[7]FAIR steht für Auffindbarkeit (Findability), Zugänglichkeit (Accessibility), Interoperabilität (Interoperability) und Wiederverwendung (Reusability) digitaler Inhalte.
-
[8]Vgl. Cugliana et al. 2024a.
-
[9]Vgl. DeRose et al. 1990.
-
[10]Vgl. Buzzetti 2002
-
[11]Vgl. DeRose et al. 1990
-
[12]
-
[13]Allen H. Renear: Theory and Metatheory in the Development of Text Encoding. 1995, #5.1.6 zitiert nach Ciula et al. 2023, S. 182.
-
[14]Vgl. Schmidt 2016.
-
[15]Vgl. Pagel et al. 2020.
-
[16]Vgl. Kuczera 2024b; Kuczera 2024a.
-
[17]
-
[18]Vgl. Kuczera 2024b, S. 2.
-
[19]Vgl. Kuczera 2024b, S. 3.
-
[20]Vgl. Kuczera 2020; Kuczera 2024a.
-
[21]Vgl. Neill / Kuczera 2019.
-
[22]Vgl. Kuczera 2024a, Abschnitt 4.
-
[23]Vgl. Enns / Kuczera 2026.
-
[24]Vgl. Tiepmar / Heyer 2017.
-
[25]Vgl. Enns / Kuczera 2025.
-
[26]Vgl. Enns / Kuczera 2025.
-
[27]Vgl. Enns et al. 2025.
-
[28]Vgl. Kuczera 2024a.
-
[29]Vgl. Enns / Kuczera 2025.
Bibliografie
- Heinrich Appelt (Hg.): Die Urkunden Friedrichs I. (Friderici I. Diplomata). Teil 2: Die Urkunden Friedrichs I. 1158–1167 (= Monumenta Germaniae Historica – Diplomata. Die Urkunden der deutschen Könige und Kaiser, 10.2). München 1979. [Nachweis im GVK]
- Dino Buzzetti: Digital Representation and the Text Model. In: New Literary History 33 (2002), H. 1, S. 61–88. DOI: 10.1353/nlh.2002.0003
- Arianna Ciula / Øyvind Eide / Cristina Marras / Patrick Sahle: Modelling Between Digital and Humanities. Thinking in Practice. Cambridge, GB 2023. DOI: 10.11647/OBP.0369
- Elisa Cugliana / Aengus Ward / Joris J. van Zundert / Andreas Kuczera / Max Grüntgens (2024a): Computational Approaches and the Epistemology of Scholarly Editing. In: International Journal of Digital Humanities 6 (2024), S. 169–188. DOI: 10.1007/s42803-024-00088-z
- Elisa Cugliana / Sebastian Enns / Andreas Kuczera (2024b): ›Sortes Dictae Sunt‹. Methods for Editing Mediaeval Books of Fortune. In: Zeitschrift für digitale Geisteswissenschaften 9 (2024). 30.10.2024. DOI: 10.17175/2024_005
- James Cummings: The Compromises and Flexibility of TEI Customisation. In: Clare Mills / Michael Pidd / Esther Ward (Hg.): DHC 2012. Digital Humanities Congress 2012. Proceedings (Sheffield, 06.–08.09.2012). Sheffield, GB 2012. [online]
- Steven J. DeRose / David G. Durand / Elli Mylonas / Allen H. Renear: 1990. What Is Text, Really? In: Journal of Computing in Higher Education 1 (1990), S. 3–26. DOI: 10.1007/BF02941632
- Sebastian Enns / Andreas Kuczera: Explicitly Notated Citations. Von digitalen zu algorithmischen Editionen. In: Nils Reiter / Thomas Haider / Daniel Kababgi / Hendrik Buschmeier(Hg.): DHd 2025. Under Construction. 11. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum. Konferenzabstracts (Bielefeld, 03.–07.03.2025). Bielefeld 2025, S. 239–242. DOI: 10.5281/zenodo.15112014
- Sebastian Enns / Stefan Armbruster / Andreas Kuczera: Graph-Based Digital Editions and TEI: Towards Interoperable and Assertive Scholarly Editing. In: Joanna Hałaczkiewicz (Hg.): TEI 2025. »New Territories«. Text Encoding Initiative and Members’ Meeting 2025. Proceedings (Krakau, 16.–20.09.2025). Kraków, S. 114–118. DOI: 10.5281/zenodo.17312233
- Sebastian Enns / Andreas Kuczera: From Abstraction to Annotation: Modelling Heterogeneous Structures in Digital Editions. In: DH 2026. »Engagement«. 36th Annual Conference of the Alliance of Digital Humanities Organizations (ADHO). Proceedings (Daejeon, KR, 27.–31.07.2026). (Im Erscheinen)
- Ronald Haentjens Dekker / David J. Birnbaum: It’s More than Just Overlap: Text As Graph. In: Balisage: The Markup Conference 2017. Proceedings (Washington, 01.–04.08.2017). Rockville, MD-USA 2017. DOI: 10.4242/BalisageVol19.Dekker01
- Andreas Kuczera: Die Regesta Imperii im digitalen Zeitalter. Das Regest als Netzwerk von Entitäten. In: Das Mittelalter 24 (2019), H. 1, S. 157–172. DOI: 10.1515/mial-2019-0011
- Andreas Kuczera: TEI Beyond XML – Digital Scholarly Editions as Provenance Knowledge Graphs. In: Tara Andrews / Franziska Diehr / Thomas Efer / Andreas Kuczera / Joris van Zundert (Hg.): GRAPH 2020. Graph Technologies in the Humanities 2020. CEUR Workshop Proceedings 3110 (Wien, 21.–22.02.2020). Bonn 2020, S. 101–123. PDF. [online]
- Andreas Kuczera (2024a): Applied Text as Graph (ATAG) in an Algorithmic Edition. In: Journal of the Text Encoding Initiative 18 (2024). DOI: 10.4000/14vyl
- Andreas Kuczera (2024b): Applied Text as Graph (ATAG). In: Joëlle Weis / Estelle Bunout / Thomas Haider (Hg.): DHd 2024. Quo Vadis. 10. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum. Konferenzabstracts (Passau, 26.02.–01.03.2024). Passau 2024. DOI: 10.5281/zenodo.10698323
- Iian Neill / Andreas Kuczera: The Codex – an Atlas of Relations. In: Andreas Kuczera / Thorsten Wübbena / Thomas Kollatz (Hg.): Die Modellierung des Zweifels (= Zeitschrift für digitale Geisteswissenschaften / Sonderbände, 4). Wolfenbüttel 2019. 08.05.2019. DOI: 10.17175/SB004_008
- Janis Pagel / Nils Reiter / Ina Rösiger /Sarah Schulz: Annotation als flexibel einsetzbare Methode. In: Nils Reiter / Axel Pichler / Jonas Kuhn (Hg.): Reflektierte algorithmische Textanalyse. Berlin u. a. 2020, S. 125–142. DOI: 10.1515/9783110693973-006
- Elena Pierazzo: Digital Scholarly Editing: Theories, Models and Methods. London u. a. 2016. [Nachweis im GVK]
- Dieter Rübsamen / Andreas Kuczera: Verborgen, vergessen, verloren? Perspektiven der Quellenerschließung durch die digitalen Regesta Imperii. In: Rainer Hering / Jürgen Sarnowsky / Christoph Schäfer / Udo Schäfer (Hg.): Forschung in der digitalen Welt. Sicherung, Erschließung und Aufbereitung von Wissensbeständen (= Veröffentlichungen aus dem Staatsarchiv der Freien und Hansestadt Hamburg, 20). Hamburg 2006, S. 109–123. PDF. [online]
- Desmond Allan Schmidt: Using Standoff Properties for Marking-Up Historical Documents in the Humanities. In: it – Information Technology 58 (2016), H. 2, S. 63–69. DOI: 10.1515/itit-2015-0030
- Jochen Tiepmar / Gerhard Heyer: An Overview of Canonical Text Services. In: Linguistics and Literature Studies 5 (2017), H. 2, S. 132–148. DOI: 10.13189/lls.2017.050209
Abbildungsverzeichnis
- Abb. 1: Buchseite aus den MGH mit einer Urkunde Friedrich Barbarossas. [Aus: Appelt (Hg.) 1979, S. 260]
- Abb. 2: Volltext des Regests RI IV,2,2 n. 1145 in den Regesta Imperii Online. [Screenshot: Andreas Kuczera 2024]
- Abb. 3: Das Regest aus Abbildung 2 im ATAG-Editor. [Screenshot: Andreas Kuczera 2024]
- Abb. 4: Das Grundmuster von ATAG: Zeichenknoten (orange), Textknoten (blau) und Annotationsknoten (grün). [Grafik: Andreas Kuczera 2023]
- Abb. 5: Der Textknoten des Briefes R2 aus dem Liber Epistolarum der Hildegard von Bingen in Neo4j mit den ersten Zeichenknoten und Annotationen. [Screenshot: Andreas Kuczera 2024]
- Abb. 6: Die ersten Wörter von Brief R2 in der Web-Publikationsumgebung. [Screenshot: Andreas Kuczera 2024]
- Abb. 7: Die ersten Wörter von Brief R2 im Original. [Fotografie: Hochschul- und Landesbibliothek RheinMain, Hs 2 [»Riesenkodex«], fol. 328r]
- Abb. 8: Der Brief von Johannes Müller (Hamburg) an Stanisław Lubieniecki (Hamburg), 5. Januar 1665, in der Graphdatenbank. [Screenshot: Andreas Kuczera 2024]
- Abb. 9: XML-Ausschnitt des Briefes von Ismaël Boulliau (Paris) an Stanisław Lubieniecki (Hamburg), 6. März 1665. [Screenshot: Andreas Kuczera 2024]
- Abb. 10: Graphenmodell: Brieftext (links), Annotation (Mitte) und Annotationen in der Annotation (blau). [Grafik: Andreas Kuczera 2023]
- Abb. 11: Der Brief Ismaël Boulliau an Stanisław Lubieniecki, 6. März 1665, in der Web-Publikationsumgebung. [Screenshot: Andreas Kuczera 2024]
- Abb. 12: Collage: Basistext des Briefes (gelb), Kommentartext (blau) und Graphmodell. [Grafik: Andreas Kuczera 2023]
- Abb. 13: Der ATAG-Editor. [Screenshot: Andreas Kuczera 2024]